Dixie Consulting — Informations vérifiées le 9 septembre 2026.
Le coût d’utilisation des modèles d’intelligence artificielle continue de diminuer rapidement.
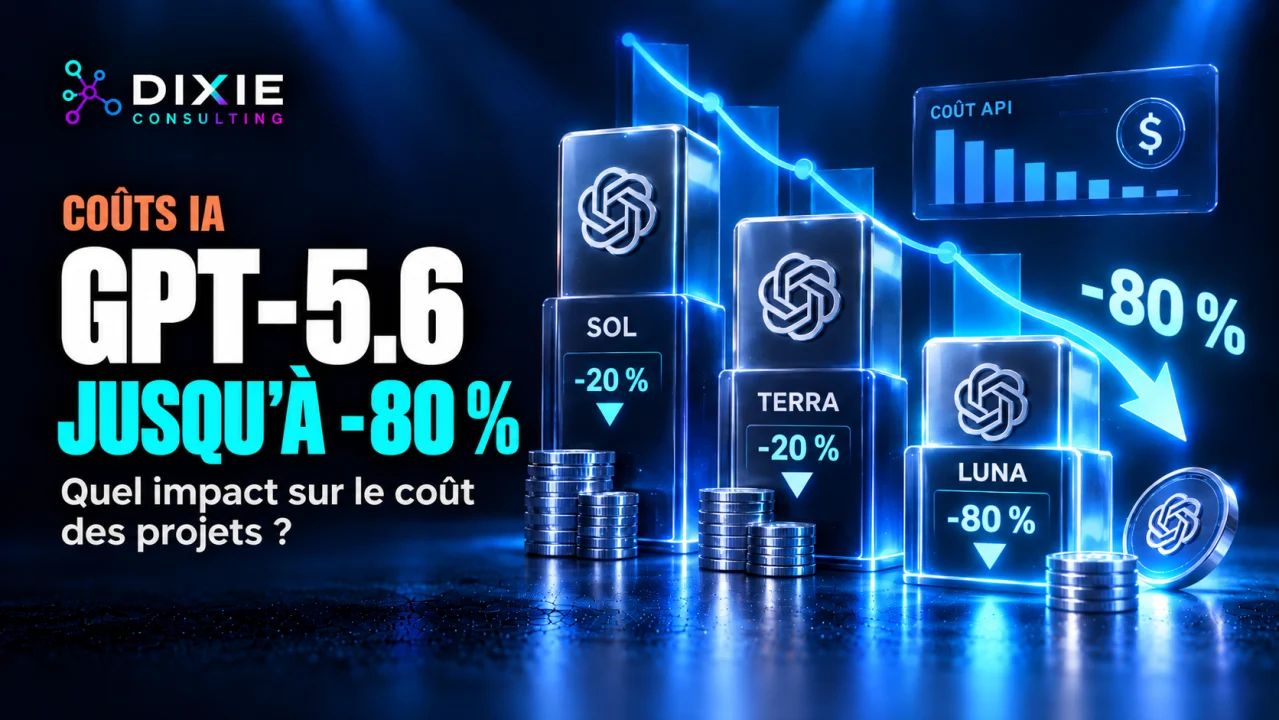
OpenAI a d’abord réduit, le 30 juillet 2026, les tarifs API de GPT-5.6 Terra et GPT-5.6 Luna. Terra a baissé de 20 %, tandis que Luna a subi une réduction beaucoup plus spectaculaire de 80 %.
Puis, le 21 août, OpenAI a également réduit temporairement le tarif de son modèle le plus puissant de la gamme, GPT-5.6 Sol : l’entrée est passée de 5 à 4 dollars par million de tokens et la sortie de 30 à 20 dollars. Cette tarification promotionnelle est annoncée comme disponible au moins jusqu’au 21 novembre 2026.
Pour une entreprise qui utilise simplement ChatGPT quelques fois par jour, ces chiffres peuvent paraître assez abstraits.
Pour une PME qui intègre l’IA dans son logiciel, son support client, son CRM ou des processus automatisés, ils peuvent au contraire changer profondément l’équation économique d’un projet.
Les nouveaux tarifs de GPT-5.6
Voici l’évolution des tarifs standards de la famille GPT-5.6, exprimés en dollars par million de tokens.
| Modèle | Ancien tarif entrée | Nouveau tarif entrée | Nouveau tarif entrée en cache | Ancien tarif sortie | Nouveau tarif sortie | Baisse |
|---|---|---|---|---|---|---|
| GPT-5.6 Sol | 5 $ | 4 $ | 0,40 $ | 30 $ | 20 $ | -20 % entrée / -33 % sortie |
| GPT-5.6 Terra | 2,50 $ | 2 $ | 0,20 $ | 15 $ | 12 $ | -20 % |
| GPT-5.6 Luna | 1 $ | 0,20 $ | 0,02 $ | 6 $ | 1,20 $ | -80 % |
Sol reste le modèle phare destiné aux tâches professionnelles complexes, Terra vise un compromis entre coût et capacités, tandis que Luna est optimisé pour les traitements sensibles au prix et aux volumes importants.
Une nuance est néanmoins importante : la baisse de Sol est promotionnelle. OpenAI indique actuellement qu’elle sera maintenue au moins jusqu’au 21 novembre 2026. Une entreprise qui construit son modèle économique autour de ce tarif doit donc prévoir une marge de sécurité.
API et abonnement ChatGPT : attention à ne pas confondre
Cette baisse concerne avant tout l’utilisation de GPT-5.6 via l’API et certains systèmes de facturation à l’usage.
Elle ne signifie pas qu’un abonnement ChatGPT Plus, Pro ou Business devient automatiquement moins cher.
OpenAI a explicitement indiqué lors de la baisse de Terra et Luna que les prix des abonnements et leurs quotas restaient inchangés. De même, la promotion actuelle de Sol ne modifie pas les usages inclus des abonnements personnels classiques.
C’est une distinction importante.
Un abonnement ChatGPT permet à un utilisateur de travailler dans l’interface d’OpenAI.
L’API permet à une entreprise d’intégrer directement le modèle dans ses propres applications et processus.
C’est par exemple l’API qui peut être utilisée pour analyser automatiquement chaque nouveau ticket SAV, classifier des milliers de documents, enrichir un CRM ou faire fonctionner un agent IA.
Combien coûte réellement une requête GPT-5.6 ?
Le principe de calcul reste simple :
coût = tokens d’entrée + tokens en cache + tokens de sortie
Prenons une interaction relativement classique avec :
- 5 000 tokens envoyés au modèle ;
- 1 000 tokens générés en réponse.
Avec GPT-5.6 Sol, cette opération aurait coûté environ :
5 000 × 5 $ / 1 000 000 + 1 000 × 30 $ / 1 000 000 = 0,055 $
Avec les nouveaux tarifs :
5 000 × 4 $ / 1 000 000 + 1 000 × 20 $ / 1 000 000 = 0,040 $
Le coût passe donc d’environ 5,5 à 4 cents, soit une baisse de 27 % dans cet exemple.
Cela paraît insignifiant.
Mais cette lecture devient très différente lorsqu’on multiplie l’opération par plusieurs centaines de milliers de demandes.
GPT-5.6 Luna change surtout l’économie des gros volumes
Le changement le plus spectaculaire concerne GPT-5.6 Luna.
Son tarif d’entrée est passé de 1 dollar à seulement 0,20 dollar par million de tokens, et sa sortie de 6 à 1,20 dollar.
Cela représente une division du coût par cinq.
OpenAI présente justement Luna comme le modèle destiné aux charges de travail à fort volume et indique que cette baisse doit rendre économiquement viables davantage d’applications agentiques et de traitements massifs.
Reprenons notre exemple précédent de 5 000 tokens entrants et 1 000 tokens générés.
Avant la baisse :
0,011 $ par requête
Aujourd’hui :
0,0022 $ par requête
À l’unité, la différence paraît toujours minuscule.
Mais pour 100 000 opérations par mois :
| Tarif | Coût |
|---|---|
| Ancien Luna | 1 100 $ |
| Nouveau Luna | 220 $ |
| Économie | 880 $ / mois |
C’est à cette échelle que la baisse devient réellement stratégique.
L’analyse documentaire devient beaucoup moins chère
Prenons maintenant une tâche beaucoup plus lourde.
Une entreprise souhaite analyser un dossier contenant l’équivalent de 100 000 tokens et générer une synthèse de 5 000 tokens.
Le coût théorique devient :
| Modèle | Avant | Aujourd’hui |
|---|---|---|
| GPT-5.6 Sol | 0,65 $ | 0,50 $ |
| GPT-5.6 Terra | 0,325 $ | 0,26 $ |
| GPT-5.6 Luna | 0,13 $ | 0,026 $ |
Avec Luna, analyser un document de cette taille revient donc théoriquement à 2,6 cents de coût modèle dans notre scénario.
Un traitement de 10 000 documents similaires représenterait environ 260 dollars de tokens.
Ce type de tarification ouvre des usages intéressants pour :
- analyser des contrats ;
- extraire des données de dossiers ;
- classifier des documents ;
- contrôler des formulaires ;
- résumer des comptes rendus ;
- analyser des retours clients ;
- enrichir automatiquement une base documentaire.
Tous ces projets existaient déjà auparavant.
La différence est que leur seuil de rentabilité baisse considérablement.
Les agents IA sont probablement les principaux bénéficiaires
La baisse peut avoir un impact encore plus important sur les agents IA.
Un chatbot traditionnel réalise souvent une seule requête.
Un agent peut, pour une seule mission :
- analyser la demande ;
- établir un plan ;
- interroger un outil ;
- analyser son résultat ;
- effectuer une deuxième recherche ;
- modifier une donnée ;
- vérifier l’opération ;
- produire une réponse finale.
Une seule action visible par l’utilisateur peut donc provoquer plusieurs appels au modèle.
Nous avons déjà expliqué pourquoi cette évolution oblige également à mieux encadrer leurs droits dans notre article consacré aux permissions et validations des agents IA : Jusqu’où laisser agir un agent IA ?
Lorsque chaque étape coûte quelques centimes, multiplier les raisonnements, contrôles et vérifications peut rapidement augmenter la facture.
Avec Luna à 0,20 dollar en entrée et 1,20 dollar en sortie, il devient beaucoup plus facile d’utiliser un petit modèle pour les opérations intermédiaires.
Il ne faut surtout pas utiliser Sol partout
C’est probablement l’une des conséquences les plus intéressantes de la gamme GPT-5.6.
Une architecture IA moderne n’a plus nécessairement intérêt à utiliser le meilleur modèle disponible pour chaque étape.
OpenAI recommande elle-même une approche dans laquelle les différents niveaux d’intelligence sont adaptés au résultat recherché.
Un workflow de développement pourrait par exemple utiliser Sol pour résoudre une difficulté ou définir un plan, puis Luna pour exécuter les opérations précisément définies, effectuer les tests ou vérifier certains résultats.
Pour une entreprise, on pourrait imaginer :
GPT-5.6 Luna
Classification d’un e-mail
↓
GPT-5.6 Luna
Extraction du client et du sujet
↓
GPT-5.6 Terra
Analyse du contexte commercial
↓
GPT-5.6 Sol uniquement si nécessaire
Résolution d’une situation complexe
↓
GPT-5.6 Luna
Mise en forme du résultat
C’est ce que l’on appelle généralement du model routing.
Au lieu de se demander :
Quel modèle devons-nous utiliser pour notre application ?
la question devient :
Quel est le modèle le moins coûteux capable de réaliser correctement chacune des étapes ?
Le prompt caching peut encore réduire la facture
La baisse des tarifs n’est pas le seul levier disponible.
GPT-5.6 bénéficie également du prompt caching.
Lorsqu’une grande partie du contexte reste identique entre plusieurs requêtes, OpenAI peut réutiliser les tokens déjà traités.
Les entrées récupérées depuis le cache bénéficient actuellement d’une réduction de 90 % par rapport au tarif d’entrée normal.
Ainsi, avec Luna :
- entrée normale : 0,20 $ / million ;
- entrée en cache : 0,02 $ / million.
Avec Sol :
- entrée normale : 4 $ / million ;
- entrée en cache : 0,40 $ / million.
La documentation de GPT-5.6 indique également que les écritures dans le cache sont facturées à 1,25 fois le tarif d’entrée normal, tandis que les lectures profitent ensuite de la réduction de 90 %.
Cela peut devenir très important pour un agent auquel on transmet systématiquement :
- les mêmes instructions ;
- les règles de l’entreprise ;
- un catalogue ;
- une documentation ;
- une longue description du workflow ;
- un schéma de données.
Le cache est donc surtout intéressant lorsqu’un même contexte est réellement réutilisé.
Les projets asynchrones disposent d’un autre levier : Batch
Les entreprises n’ont pas toujours besoin d’une réponse immédiate.
Analyser 50 000 documents pendant la nuit n’impose pas la même latence qu’un chatbot utilisé par un client.
OpenAI propose également son traitement Batch, avec une réduction pouvant atteindre 50 % par rapport au traitement standard pour les charges compatibles.
La combinaison devient particulièrement intéressante :
modèle moins cher + cache + traitement par lots
Dans certains projets à très fort volume, l’optimisation de l’architecture peut donc produire des économies encore supérieures à la simple baisse affichée des tarifs.
Trois projets qui deviennent plus intéressants pour une PME
1. Classifier automatiquement les e-mails et tickets
Un modèle comme Luna peut identifier :
- le type de demande ;
- le client concerné ;
- l’urgence ;
- le service compétent ;
- le sentiment ;
- l’action suivante.
Lorsqu’une entreprise reçoit quelques milliers de messages par mois, le coût du modèle devient parfois marginal par rapport au temps humain économisé.
2. Construire un moteur d’analyse documentaire
Factures, devis, contrats, comptes rendus et documents techniques peuvent être analysés automatiquement.
Le passage de Luna à 20 cents par million de tokens entrants rend particulièrement intéressante l’exploitation de volumes documentaires importants.
3. Faire fonctionner des agents en arrière-plan
Un agent peut régulièrement :
- surveiller de nouvelles données ;
- classer les informations ;
- rechercher des anomalies ;
- préparer des tâches ;
- vérifier des dossiers ;
- enrichir une base.
Ce sont précisément des opérations qui nécessitent énormément d’appels mais pas nécessairement le modèle le plus puissant du marché.
Le prix du token ne représente toutefois pas le coût d’un projet IA
Il serait tentant d’en conclure qu’un projet d’intelligence artificielle ne coûte désormais presque plus rien.
Ce serait une erreur.
Le modèle n’est qu’une composante du coût réel.
Il faut également prendre en compte :
- le développement ;
- l’hébergement ;
- les bases de données ;
- les outils connectés ;
- les recherches Web éventuelles ;
- le stockage vectoriel ;
- l’observabilité ;
- les contrôles de sécurité ;
- les évaluations ;
- les erreurs et nouvelles tentatives ;
- la maintenance ;
- le contrôle humain.
C’est précisément pourquoi il est préférable de mesurer le coût d’une tâche correctement réalisée plutôt que le seul coût d’un million de tokens.
Nous avons détaillé cette approche dans notre dossier consacré au FinOps IA : FinOps IA : combien vous coûte vraiment une tâche réalisée par ChatGPT, Claude ou Gemini ?
Un modèle deux fois plus cher peut rester économiquement préférable s’il réduit fortement le nombre d’erreurs ou d’interventions humaines.
Comparer les modèles devient plus important que jamais
La baisse de GPT-5.6 renforce également la concurrence entre fournisseurs.
DeepSeek, Google, Anthropic, OpenAI et les modèles ouverts proposent désormais des niveaux de prix extrêmement différents.
Comparer simplement deux prix par million de tokens n’est cependant pas suffisant.
Une entreprise doit mesurer au minimum :
qualité obtenue × nombre de tokens × nombre de tentatives × temps humain nécessaire
Nous avions déjà commencé à comparer cette logique tarifaire dans notre article sur les différences de prix entre les API DeepSeek et GPT : DeepSeek vs GPT : comparaison des prix et plans d’API
Les nouvelles baisses de GPT-5.6 montrent à quel point ces comparatifs doivent être régulièrement actualisés.
Que devrait faire une PME qui utilise déjà l’API OpenAI ?
La première réaction ne devrait pas nécessairement être de modifier immédiatement son application.
Il est préférable de reprendre quelques tâches réellement représentatives et de mesurer leur coût.
Par exemple :
| Tâche | Modèle actuel | Coût moyen | Modèle à tester |
|---|---|---|---|
| Classification d’un message | Sol | 0,02 € | Luna |
| Extraction documentaire | Terra | 0,05 € | Luna |
| Réponse commerciale complexe | Sol | 0,15 € | Terra / Sol |
| Analyse stratégique | Sol | 0,40 € | Sol |
| Vérification automatique | Terra | 0,03 € | Luna |
Les valeurs ci-dessus sont uniquement illustratives.
La méthode, en revanche, est importante.
Il faut tester chaque modèle sur les vraies données du projet, mesurer le taux de réussite, puis descendre progressivement vers le modèle le moins coûteux qui conserve la qualité nécessaire.
Une baisse de prix peut aussi servir à augmenter la qualité
Il existe enfin une autre manière d’utiliser ces économies.
Au lieu de simplement réduire la facture, une entreprise peut conserver le même budget et utiliser la différence pour :
- ajouter une vérification supplémentaire ;
- comparer deux réponses ;
- effectuer davantage de contrôles ;
- utiliser un contexte plus complet ;
- traiter davantage de données ;
- lancer des évaluations automatiques ;
- ajouter un modèle de contrôle après une première réponse.
La baisse du prix de l’intelligence artificielle ne signifie donc pas nécessairement :
faire exactement la même chose moins cher.
Elle peut aussi signifier :
obtenir un meilleur résultat pour le même budget.
Et c’est probablement l’impact le plus intéressant à moyen terme.
Conclusion
La baisse des tarifs de GPT-5.6 ne constitue pas simplement une nouvelle guerre des prix entre fournisseurs d’IA.
Elle modifie progressivement le seuil économique à partir duquel une automatisation devient rentable.
La réduction de 20 % sur Terra est appréciable.
La baisse temporaire de Sol rend les tâches complexes moins coûteuses.
Mais le changement le plus important vient probablement de GPT-5.6 Luna et de sa réduction de 80 %.
À seulement 0,20 dollar par million de tokens entrants et 1,20 dollar par million de tokens générés, les traitements à très grande échelle, les contrôles automatiques et les agents fonctionnant en arrière-plan deviennent nettement plus accessibles.
Pour les TPE et PME, la bonne stratégie n’est cependant pas de remplacer systématiquement leurs modèles actuels par Luna.
Elle consiste plutôt à découper leurs processus et à utiliser le niveau d’intelligence réellement nécessaire à chaque étape.
L’avenir des projets IA pourrait ainsi moins dépendre du choix d’un modèle unique que de la capacité à combiner intelligemment Sol, Terra et Luna afin d’obtenir le meilleur coût par résultat utile.
